
核心观点
26年8月以来,头部模型厂商连续披露RSI(Recursive Self-Improvement)相关进展。OpenAI和Anthropic相继披露内部AI研发自动化数据,智谱也在博客中公布Infra Agent参与GLM-5.3-Flash推理基础设施优化的实践。我们认为,RSI已经开始进入真实模型研发和生产系统,其进展也开始可以通过AI主导研发任务占比、Agent工作量等量化指标进行观察。当前公开实践主要集中在研发自动化和系统优化环节,后续可以持续关注AI在跨任务经验复用和跨模型代际继承方面的表现。随着AI承担更多实验和执行工作,我们看好基础模型、算力、CPU及AI安全与模型可观测性相关需求。
RSI进入可度量阶段,AI开始承担真实研发任务
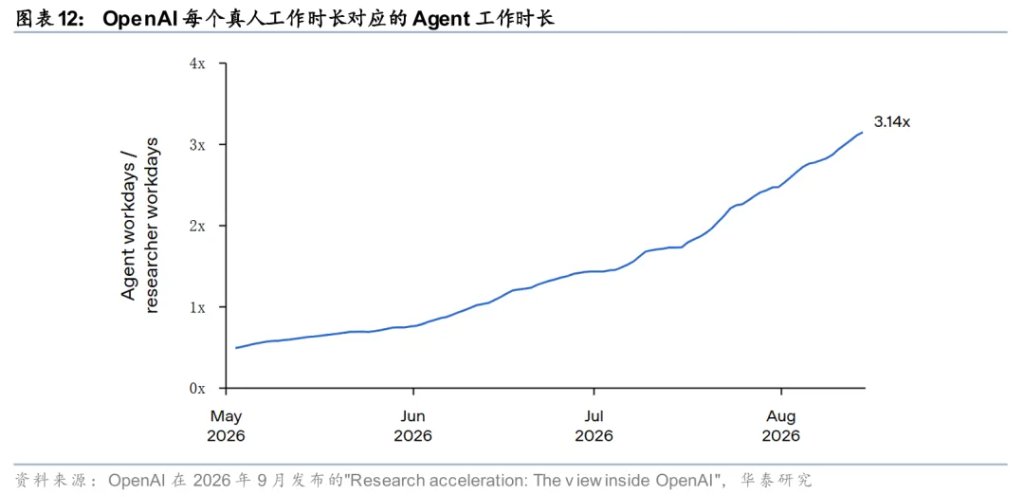
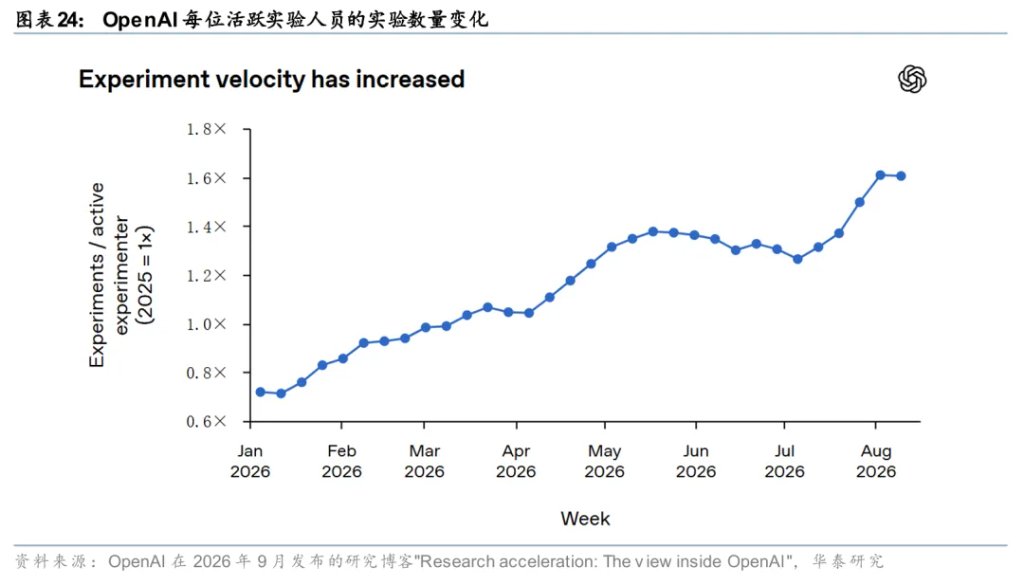
Anthropic博客数据显示,截至2026年8月,Claude已在26%的AI研发任务中达到AI主导,超过90%的任务达到AI协作及以上;OpenAI在博客中提到,截至8月中旬,研究组织中Agent的日均运行时长已相当于人类研究人员工作时长的3.1倍,每位活跃实验人员的实验数量达到统计以来高位。当前AI参与较多的环节集中在实验执行,已覆盖代码编写、实验运行和结果分析,并开始向AI4S场景中的实验设计与反馈闭环延伸,但高层研究判断的自动化程度相对较低。我们认为,AI研发自动化已经开始改变研发投入结构,模型迭代速度后续更取决于验证效率和研究判断能力。
厂商路径开始分化,改进对象逐步覆盖算法与研发系统
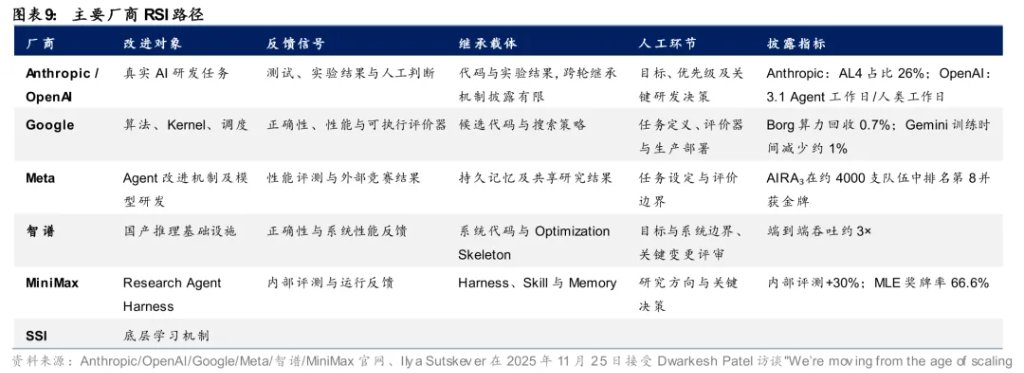
头部模型厂商已经形成不同的RSI实现路径。Anthropic和OpenAI重点提高AI在真实研究任务中的参与度;Google推进算法搜索,并让历史探索轨迹影响后续搜索方式;Meta强调跨任务经验积累,探索基于持久记忆的Agent自我改进;智谱将RSI用于推理基础设施优化,博客中提到GLM-5.3-Flash端到端吞吐较初始基线提升约3倍;MiniMax M2.7修改Research Harness,博客中提到自主迭代后内部评测提升约30%;SSI更关注泛化能力和持续学习,尝试将学习结果持续转化为模型能力。我们认为,当前RSI实践已经开始形成可保留的改进结果,代码、Harness和搜索策略可以继续用于后续任务,跨任务复用将成为下一阶段的重要观察指标。
可验证性、长时程、继承与研究判断是RSI未来扩张的重要约束
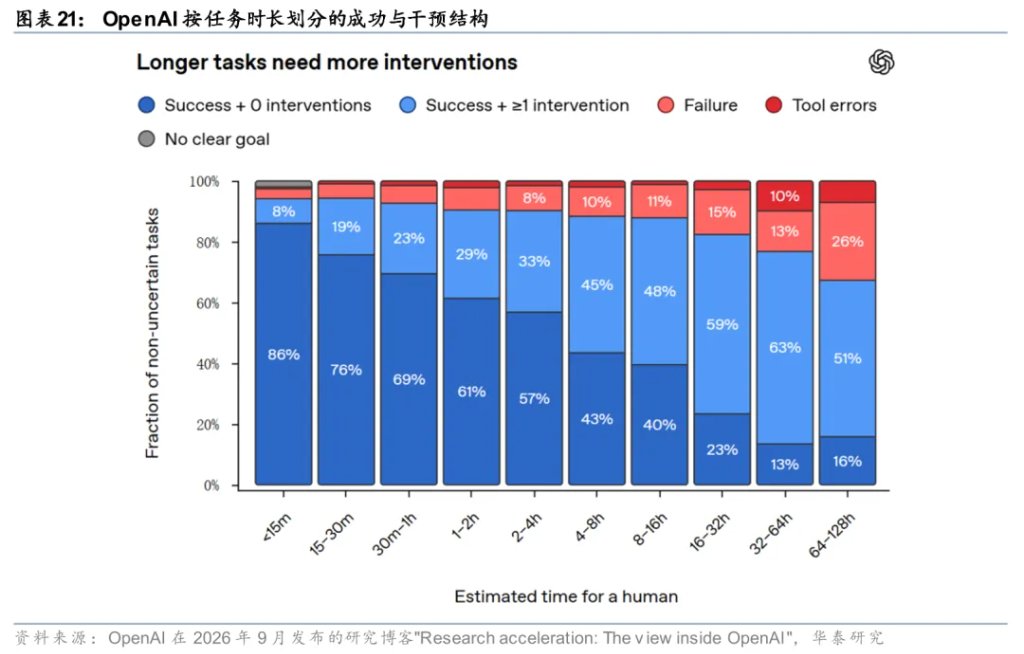
RSI目前进展较快的任务普遍具备较强的可验证性。代码可以通过测试判断结果,Kernel和Infra可以直接比较性能指标,开放研究问题则更依赖人工判断;随着实验量增加,验证误差可能在多轮迭代中累积。OpenAI博客中的数据显示,在成功完成的4-8小时研究任务中,50%以上至少发生一次人工干预,表明任务时间拉长后,状态管理和异常恢复对Agent自主性的影响明显增加。我们认为,验证可靠性、长时程自主性和跨轮继承是RSI未来扩张的重要约束,研究判断能力则影响实验规模和研发效率能否继续提升。
结论
我们建议关注四条投资主线:1)基础模型。RSI有望加快模型迭代并提升研发效率,看好领先基模厂商。2)算力。RSI提高单个研究员能够管理的Agent数量和实验并发度,同时增加验证和复现计算,算力需求有望提升。3)CPU。长时程研发Agent需要持续调用外部工具,多Agent并行还会增加任务调度和环境交互,CPU侧执行负载有望随Agent规模扩大。4)AI安全及可观测性。RSI提高Agent自我迭代能力后,异常检测及行为记录的重要性上升,建议关注AI安全及Infra侧模型可观测性相关方向。
正文
RSI进入可度量阶段:AI开始承担自我改进流程
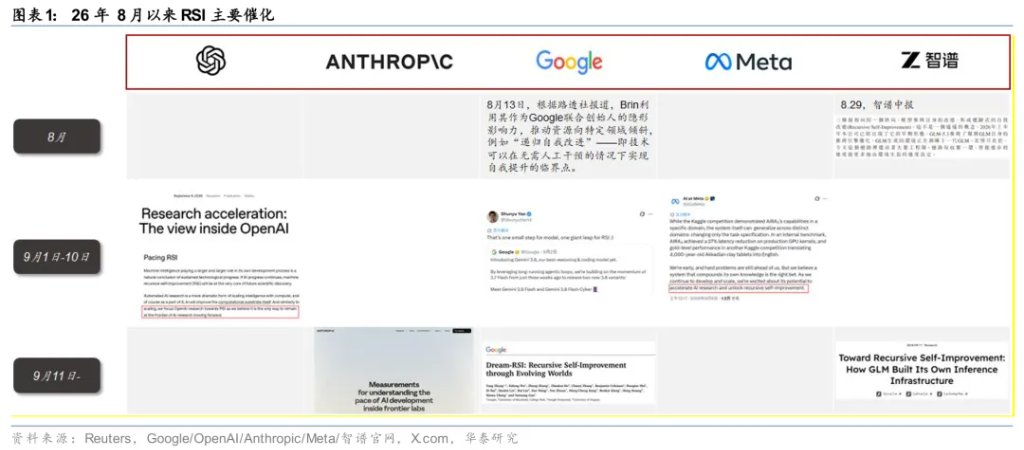
26年8月以来,RSI公开讨论明显升温,厂商开始披露RSI在真实研发活动和生产系统的应用。8月12日,Reuters报道,Google联合创始人Sergey Brin推动资源向RSI等方向倾斜,以加快Gemini研发;9月2日Gemini 3.8 Flash发布后,Google DeepMind研究员Shunyu Yao在X上称其为“one giant leap for RSI"。 9月5日,Meta官方披露AIRA₃,并表示其长期运行Agent有望通过持续积累研究结果推动RSI。9月6日,OpenAI公布内部AI研发自动化数据,展示内部RSI进程,首席科学家Jakub Pachocki同期在"An Alien Mind"中专门讨论Pacing RSI,将RSI列为研究重点;9月17日,Anthropic发布"Measurements for understanding the pace of AI development inside frontier labs",披露AI研发任务的自动化程度;同日,智谱以“Toward Recursive Self-Improvement"为题披露Infra Agent参与GLM-5.3-Flash推理基础设施优化。我们认为,近期头部模型厂商密集披露RSI相关进展,体现出RSI在下一代模型竞争中的重要性正在提升,相关实践开始进入模型研发、算法搜索和基础设施优化等环节。
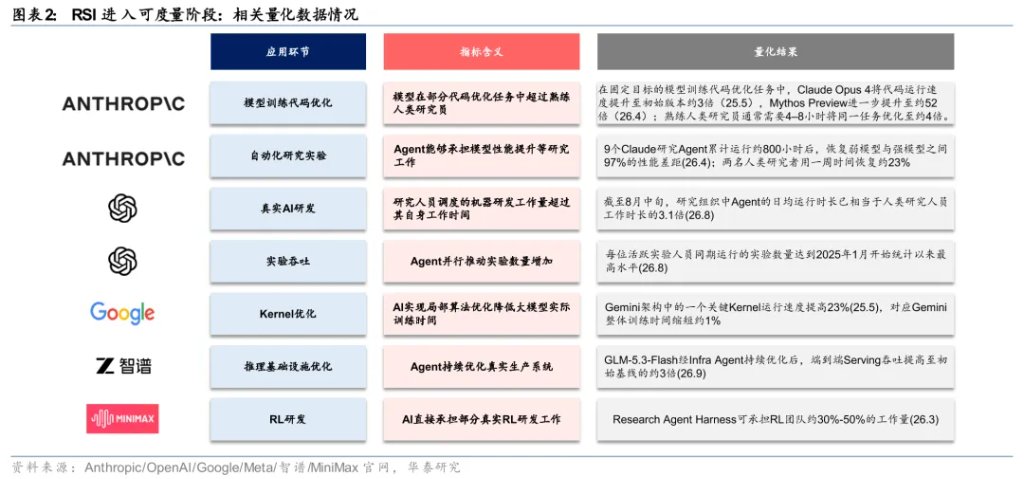
RSI对研发的影响开始可量化。根据Anthropic在2026年6月发布的"When AI builds itself",在固定目标的模型训练代码优化任务中,Claude Opus 4将代码运行速度提升至初始版本约3倍,Mythos Preview进一步提升至约52倍;作为对照,熟练人类研究员通常需要4–8小时将同一任务优化至约4倍。根据OpenAI在2026年9月发布的"Research acceleration: The view inside OpenAI",截至8月中旬,研究组织中Agent的日均运行时长已相当于人类研究人员工作时长的3.1倍。工程环节同样开始体现效率改善,根据Google DeepMind在2025年5月发布的"AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms",AlphaEvolve将Gemini架构中的关键Kernel运行速度提高23%;根据智谱在2026年9月发布的"Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure",Infra Agent将GLM-5.3-Flash端到端Serving吞吐提高至初始基线的约3倍;根据MiniMax在2026年3月发布的"MiniMax M2.7: Early Echoes of Self-Evolution",Research Agent Harness可承担RL团队约30%-50%的工作量。我们认为,RSI带来的效率改善已经可以在代码优化、研发工作量和基础设施性能等环节量化。
RSI的核心特征:改进结果进入下一轮研发
RSI的全称是Recursive Self-Improvement,分开来看重点在于递归和改进。
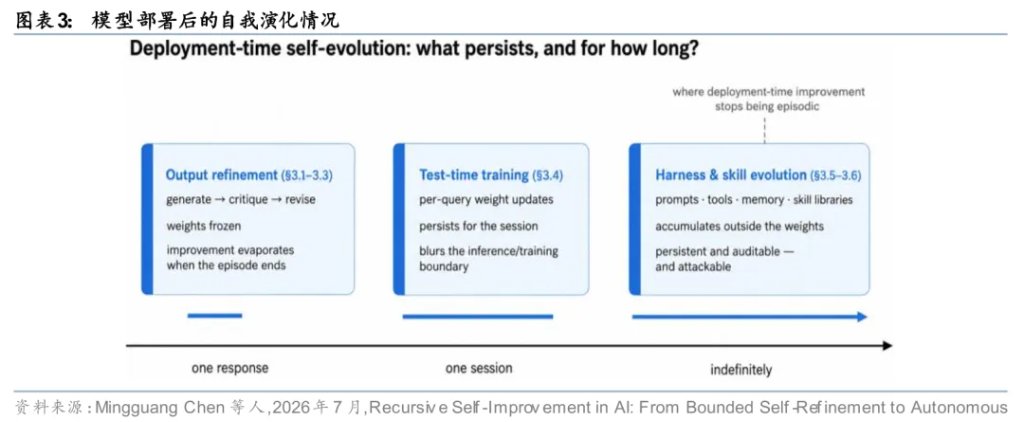
改进:需要能形成持久的影响。单个任务的自我迭代、代码修复或训练数据生成可以提高单次任务表现,但只有当改进思路被直接写入模型参数、记忆、Harness或其他基础设施,并影响继任系统的后续行为时,系统才具备跨轮积累能力。
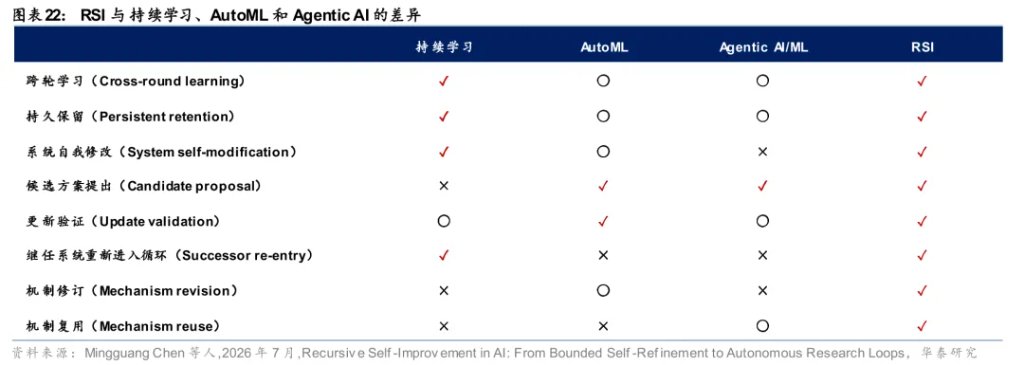
递归性要求系统进一步参与改进过程。较完整的闭环不仅包括生成候选修改,还要能够获取经验、评估修改效果、保留有效结果,并让更新后的系统继续参与下一轮改进。如果搜索策略、评价机制或Harness始终由人工预先设定,系统主要是在既定框架内提高任务自动化率;当系统能够根据历史结果调整这些机制,并用新的机制继续推动后续优化时,才开始体现递归式自我改进。
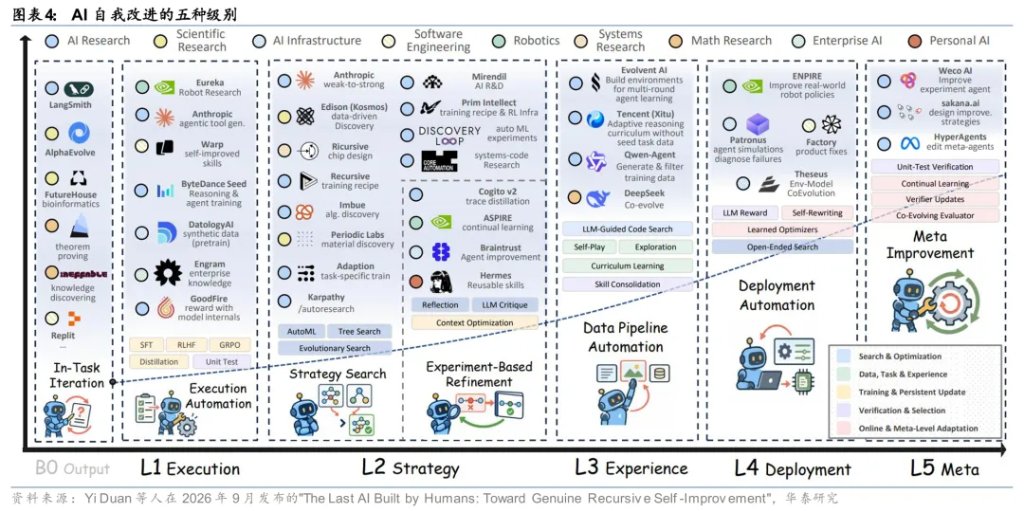
五级Autonomy框架:AI逐步接管改进策略与经验获取
Yi Duan等人在2026年9月发布的"The Last AI Built by Humans"中,用L1-L5描述AI在自我改进流程中的自治程度。L1主要按照人类预设流程执行任务;L2可以选择改进策略;L3进一步决定需要获取哪些经验和实验数据;L4能够在部署过程中根据环境持续调整自身状态,并保留相关经验;L5则开始修改产生后续改进的方法,包括候选如何生成、搜索如何进行、结果如何评价。层级提高后,人类更多负责目标、预算和安全边界,具体研发过程逐步交给AI。我们认为目前公开案例主要落在L2-L4,预计下一阶段的增量将更多集中在经验获取自动化,以及Harness、Memory和搜索策略的跨任务持续更新。
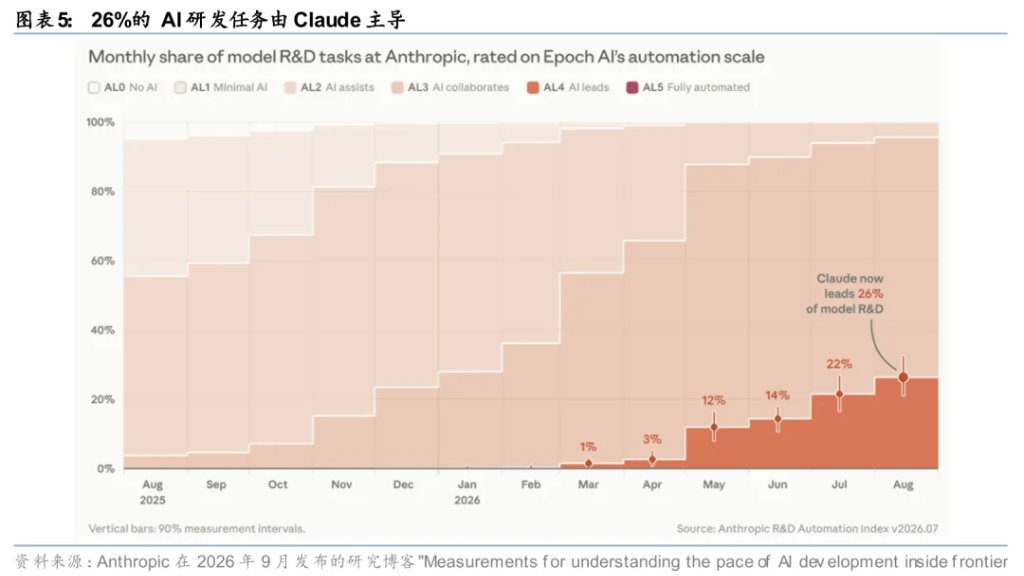
AI研发自动化影响真实研发,各环节自动化率提升
AI研发自动化已经开始影响真实研发。Anthropic在2026年9月发布的研究博客"Measurements for understanding the pace of AI development inside frontier labs"中披露,截至2026年8月,Claude在26%的AI研发工作中达到AI主导,超过90%的工作达到AI协作或更高;OpenAI在2026年9月发布的研究博客"Research acceleration: The view inside OpenAI"中披露,截至8月中旬,研究组织中Agent的日均运行时长已相当于人类研究人员工作时长的3.1倍。Anthropic和OpenAI披露的数据,分别从工作分配和工作量上体现出AI研发自动化正在深入真实研发任务。
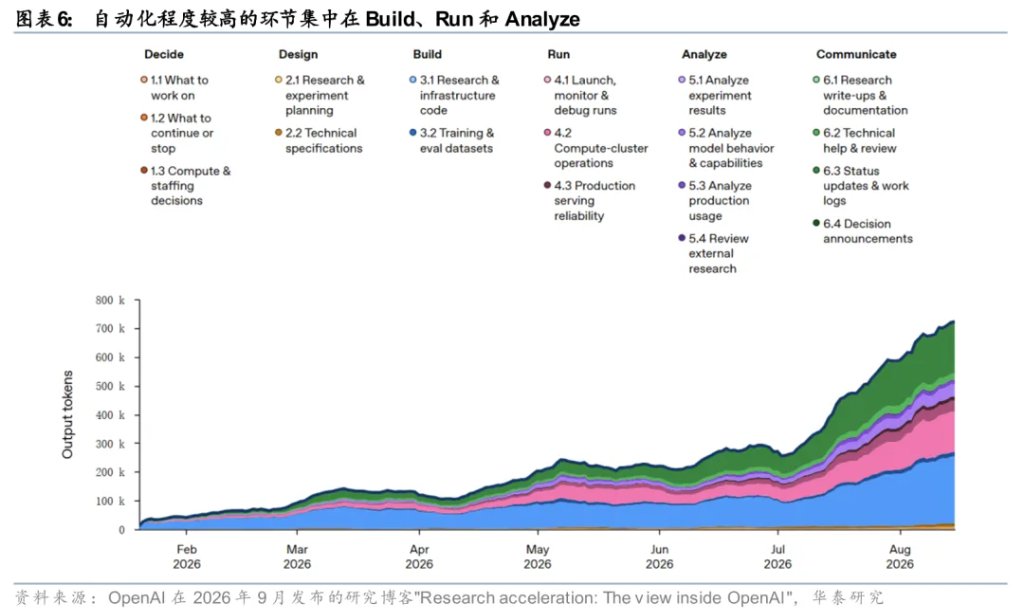
自动化程度较高的环节集中在Build、Run和Analyze等执行环节,但从整体看各环节自动化程度都在逐步提升。OpenAI在2026年9月发布的研究博客"Research acceleration: The view inside OpenAI"中展示了不同研发环节的Agent输出Token情况。当前Agent更多参与Build、Run和Analyze等执行环节,Decide和Design等高层任务的使用相对较少,但2026年以来,各类研发活动中的Agent使用均有所增加。
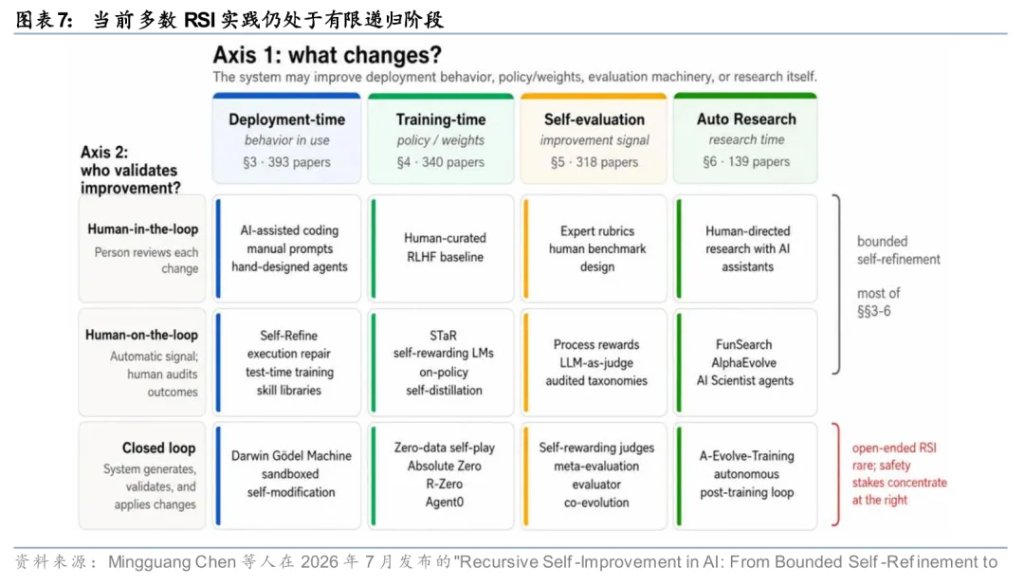
当前产业实践处于有限递归阶段:集中在可量化环节,延伸至AI4S领域
当前进展最快的RSI任务主要集中在结果容易量化的环节。代码可以通过测试和编译结果判断,Kernel能够直接比较时延和吞吐,数学证明可以接入形式化验证,推理基础设施也有明确的性能指标。Google DeepMind在2025年5月发布的博客"AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms"、智谱和MiniMax的公开案例都已经覆盖修改、实验和结果评价,并能够根据反馈持续迭代。我们认为,这类任务已经具备较完整的局部闭环,也是当前RSI最先落地的场景。
目前的公开实验主要集中在算法、搜索策略、Harness和Infra等局部对象,距离完整的跨代际自我改进还有明显差距。Anthropic弱监督研究实验中,Agent恢复了97%的性能差距,但实验问题和Rubric均由人类预先设定;Google DeepMind的"AlphaEvolve"聚焦算法搜索,Tong Zheng等人在2026年9月发布的"Dream-RSI: Recursive Self-Improvement through Evolving Worlds"进一步优化探索策略,智谱和MiniMax则分别改进推理Infra和Research Harness。我们认为,当前RSI已经能够让部分改进结果进入下一轮任务,但能否进一步跨任务复用,并延续到后续模型或研发系统,将决定其递归程度能否继续提高。
AI4S领域已经开始出现具备RSI特征的研发闭环,生命科学、芯片设计是潜在落地方向。Kusne和McDannald在2026年7月发布的"Managing autonomous materials labs with multi-agent AI and its implications for the science of science"中提出,单Agent或多Agent可以管理材料实验室,并根据实验反馈持续选择下一步实验。Danaher在2026年10月7日宣布计划建设公司首个AI自主实验室,由AI设计抗体等亲和试剂,机器人完成样品构建和测试,再将每次实验结果反馈给模型,用于下一轮候选设计。公司计划于2027年初实现规模化运行,目标将亲和试剂发现速度最高提升8倍,年试剂生成量由数十个提高至数百个,对应最高约10倍的产出提升。芯片设计领域,AlphaEvolve也已经参与下一代TPU电路、数据中心调度等实际工程优化。我们认为生命科学和芯片设计已经开始出现具备RSI特征的研发闭环,AI4S有望成为RSI相关机制在实体科研中的重要应用场景。
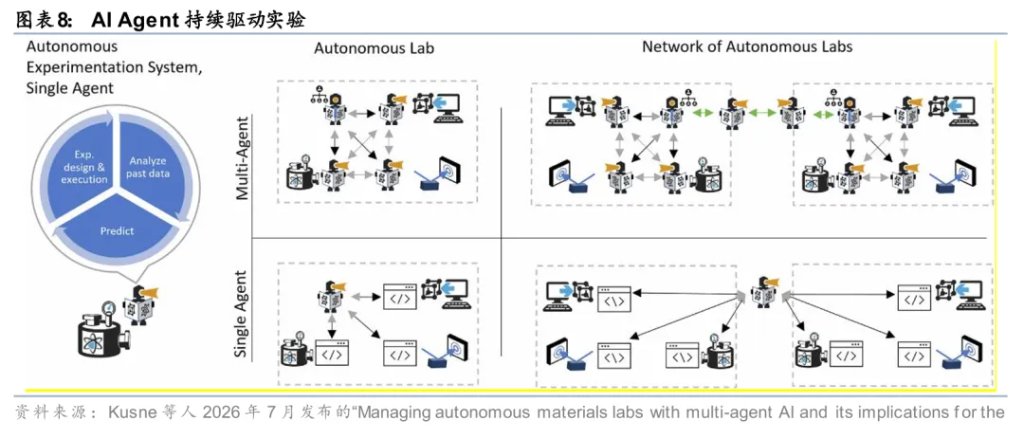
实体科研中的递归速度目前受到现实实验反馈的约束,成熟度整体低于代码、Kernel等纯数字任务。Geoffrey Hinton等人在2026年9月发布的"What if automating AI R&D triggers an intelligence explosion?"中指出,AI研发中的Agent可以快速测试改动、观察结果,并识别哪些改动能够加速自身进步;生物学等领域则更多依赖更慢、噪声更大或成本更高的现实世界反馈。实体科研还需要经过样品制备、实验执行和结果表征等物理环节,单轮反馈周期更长,部分实验也难以大规模并行。我们认为,生命科学和材料等领域目前更接近有限递归下的自动化研发闭环,物理实验周期、反馈质量和实验资源将在当前阶段共同限制自我改进速度。
模型厂商RSI路径:研发自动化与系统自进化并行
我们认为,头部模型厂商的RSI实践已经形成较为明显的分化。Anthropic和OpenAI主要推进真实AI研发任务自动化,重点提高代码、实验和研究工作流中的Agent参与度;Google重点发展可验证搜索及搜索策略自改进;Meta同时推进自修改机制与AI研究智能体;智谱将AI用于国产推理基础设施建设;MiniMax把Research Harness纳入改进对象;SSI更偏向泛化、样本效率与持续学习等底层学习机制。不同厂商的切入点与自身研发资产和工程场景有关,已披露的工程实践大多优先选择反馈清晰、结果可验证的环节。
当前部分系统已经能够在完成修改后,根据测试结果、性能指标或内部Eval决定是否保留,并将有效改进继续用于后续任务。在已披露案例中,目标设定、评价器设计和关键研究决策大多仍由人类负责。我们判断,后续更值得关注的是改进结果能否跨任务复用,以及这种复用能否持续降低人工投入、实验成本和搜索开销。
Anthropic:以任务自治指数衡量AI主导研发的进度
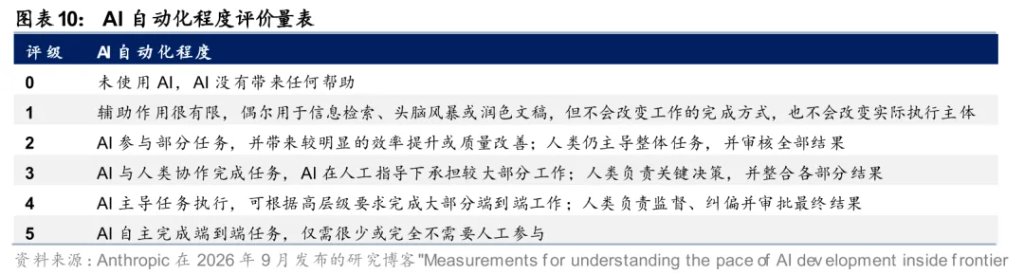
Anthropic将RSI的进展重点放在AI能否承担越来越完整的AI研发流程,并最终在较少人类参与的情况下开发后续模型。Anthropic在2026年6月发布的研究博客"When AI builds itself"中,将完整RSI对应到AI能够自主设计并开发自己的继任者;到2026年9月发布"Measurements for understanding the pace of AI development inside frontier labs"时,公司进一步用R&D Automation Index衡量Claude在真实AI研发任务中的自主程度,并划分AL0-AL5六个等级,其中AL4代表AI可以根据高层指令完成大部分端到端任务,AL5对应完全无人参与。我们认为,相比代码生成比例,这一指标更直接反映AI在真实研发流程中的自主程度,也更接近Anthropic对RSI进展的衡量口径。
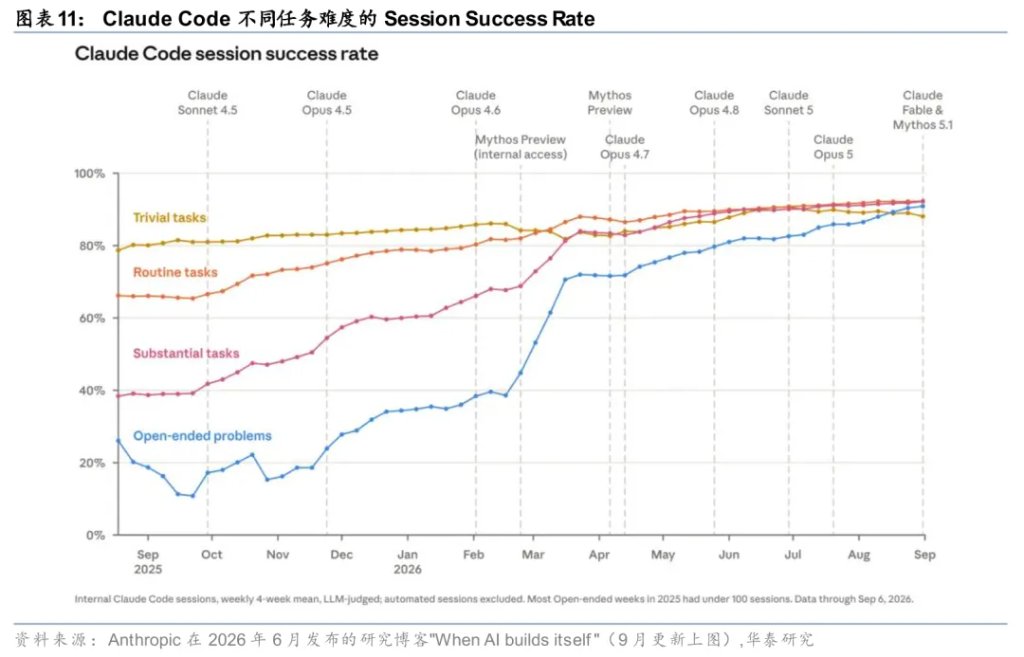
Claude在RSI相关能力上的进步主要体现在实验执行效率和局部研究判断两个环节。Anthropic在2026年4月发布的Alignment Science Blog"Automated Weak-to-Strong Researcher"显示,9个Claude研究Agent能够自主提出假设、设计实验、训练模型并共享结果,在约800小时累计研究时间内弥补97%的性能差距,而两名人类研究者一周恢复约23%。我们认为,Claude已经具备较强的实验执行能力。根据Anthropic在2026年6月发布的"When AI builds itself",在固定目标的模型训练代码优化任务中,Claude Opus 4于2025年5月平均实现约3倍加速,到2026年4月内部模型Mythos Preview提高至约52倍,同一任务中熟练人类研究员用4-8小时通常达到约4倍。与此同时,Claude Code在不同难度任务中的Session Success Rate持续提升,表明模型处理更复杂研发任务的能力在持续提高。
RSI能力已经开始反映在Anthropic真实模型研发中的任务分工上。根据Anthropic在2026年9月发布的"Measurements for understanding the pace of AI development inside frontier labs",达到AI主导的研发任务占比由2026年2月不足1%提高至8月的26%,AI协作及以上占比超过90%,但尚无任何被统计的研发任务达到完全自主。Anthropic同时开始跟踪研发Agent的监控覆盖、审查延迟和异常升级等指标。我们判断,Anthropic目前的RSI进展已经覆盖确定目标下的实验执行、局部实验设计和部分研究判断,真实研发中的AI主导任务占比也在快速提高。
OpenAI:自动化AI研究员,模型自改进能力和真实研发参与度同步提高
OpenAI将RSI进展重点放在自动化AI研究员能力上。OpenAI在2026年9月发布的研究博客"Research acceleration: The view inside OpenAI"中表示,其目标是构建在人工监督下推进深度学习与对齐研究的自动化AI研究员,并通过持续迭代提高后续模型能力;公司已经实现此前设定的自动研究实习生目标,即AI能够在人类指导下独立完成原本需要熟练研究员数天的明确研究任务,并计划在2028年3月前进一步形成更完整的自动化AI研究员。OpenAI首席科学家Jakub Pachocki在2026年9月发布的博客"An Alien Mind"中进一步提出,机器智能将在自身研发过程中承担越来越大的作用,并将其视为RSI的重要方向。我们认为,OpenAI对RSI进展的衡量重点是AI能否在人工监督下独立完成完整的真实研究任务,并提高后续研发效率。
模型能力提升已经开始转化为真实研发中的Agent工作量和实验吞吐。根据OpenAI在2026年9月发布的"Research acceleration: The view inside OpenAI",2026年6月以前,研究组织的Agent总运行时间低于人类研究人员的总工作时间;到8月中旬,研究组织中Agent的日均运行时长已相当于人类研究人员工作时长的3.1倍。同时,每位活跃实验人员的实验数量在2026年8月达到2025年1月开始统计以来最高水平。我们认为,Agent开始承担更多研发工作后,单个研究员能够并行管理的机器工作量和实验数量均在提高。
OpenAI的研发自动化在过去几个月进一步深入到实验模型训练和底层系统优化。据The Information在2026年9月21日的报道,OpenAI研究人员表示,AI已经基本实现新实验模型训练流程的自动化,内部模型也已能够编写模型在GPU上训练和运行所需的Kernel及其优化代码;工程师只需提供一个目标优化示例,模型即可连续运行数周完成相关优化。报道同时提到,多个Agent已经可以在没有人类介入的情况下协作解决问题。随着服务器资源增加,OpenAI过去因算力不足而难以及时验证的部分模型改进方法开始加快落地。我们认为,这一变化意味着OpenAI的RSI进展同时受到模型能力提升和实验算力扩张推动,AI在训练、Kernel优化和多Agent协作中的参与度继续提高。
Google:算法搜索与探索策略进入自改进闭环
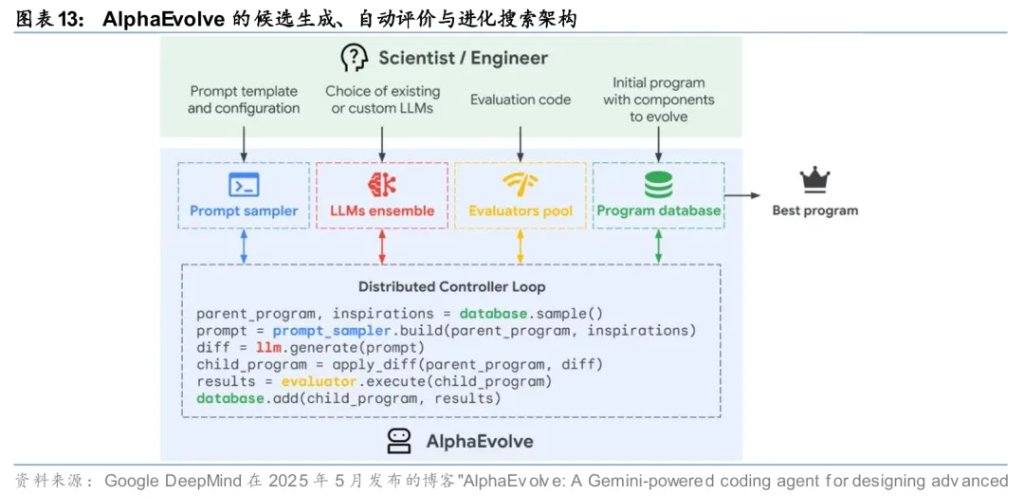
基于Google的论文,我们注意到Google的RSI路径存在差异化,Google以可验证搜索为起点,通过搜索最优路径进行优化。Google DeepMind在2025年5月发布的博客"AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms"中,介绍了由Gemini生成候选程序、自动评价器打分、进化算法持续筛选的算法搜索框架,其中Gemini架构中的关键Kernel加速23%,对应训练时间下降约1%。Google DeepMind在2026年5月发布的博客"AlphaEvolve: How our Gemini-powered coding agent is scaling impact across fields"中进一步披露,AlphaEvolve已成为Google基础设施中的常用优化工具,并参与下一代TPU电路、缓存策略和Spanner等系统优化。
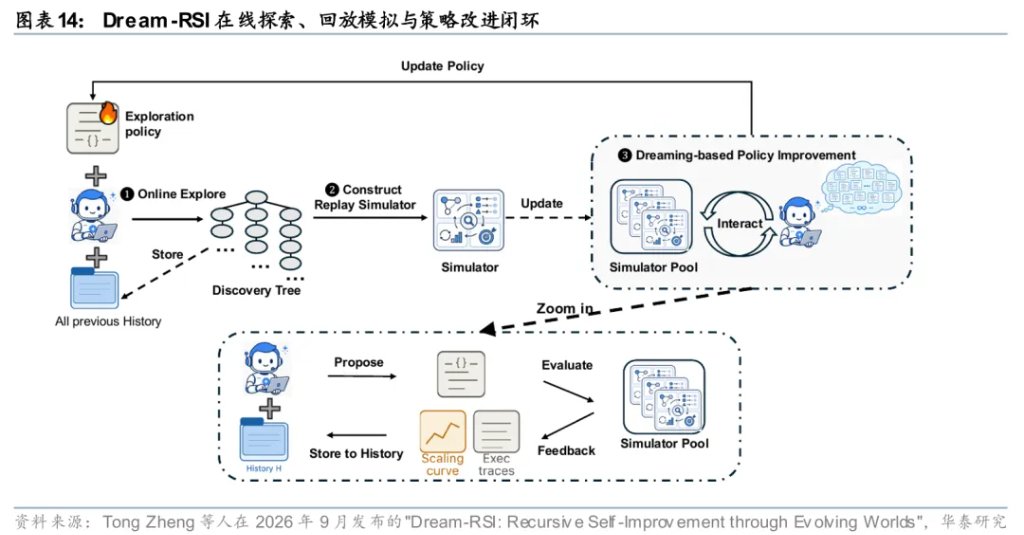
Google的近期进展是搜索策略本身开始成为改进对象,使历史探索经验能够影响下一轮搜索方式。Tong Zheng等人在2026年9月发布的"Dream-RSI: Recursive Self-Improvement through Evolving Worlds"中,让Coding Agent构建Discovery Tree,再将历史探索轨迹转化为Replay Simulator,由Policy Development Agent测试新的探索策略并部署表现更好的策略;实验中,GPU Kernel任务在达到相同性能时,所需Generation最多降至基线的约1/2.43;在相同预算下,性能最高达到基线的约2.09倍;部分算法任务的Agent调用次数最低降至对比方法的约1/162。我们认为,Google当前相关实践已经同时覆盖自动搜索优解和利用历史轨迹改进后续搜索策略,使搜索效率能够跨轮积累,实现持续迭代。
Meta:基于持久记忆的Agent自我改进
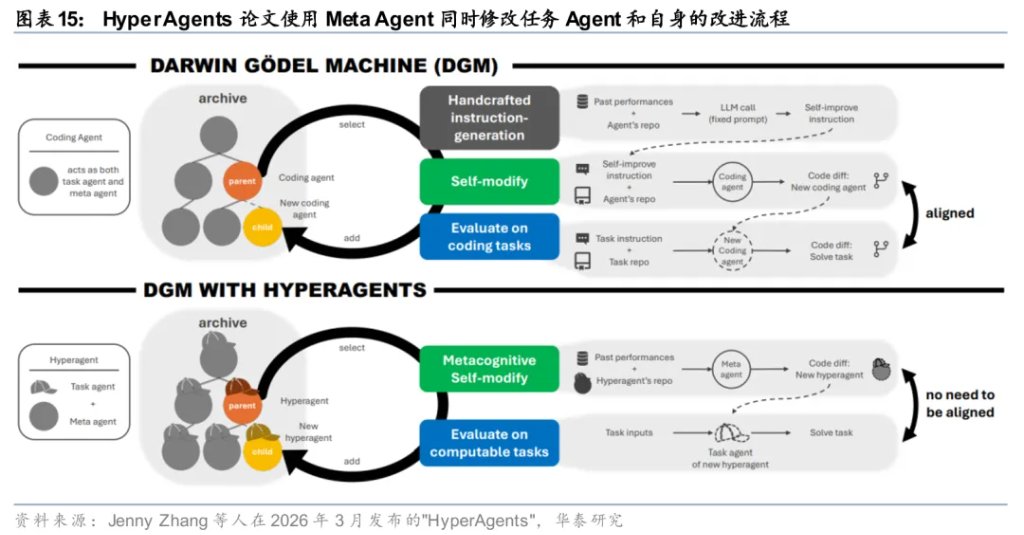
Meta的RSI路径强调AI直接参与自身研发,并进一步优化改进方法。Jenny Zhang等人在2026年3月发布的"HyperAgents"中,将任务Agent与Meta Agent整合进同一个可编辑程序,使Meta Agent能够同时修改任务Agent和自身的改进流程,并通过持久记忆和性能追踪积累跨任务经验。 2026年9月5日,Meta官方AI at Meta账号进一步披露AIRA₃:系统由多个长期运行的研究Agent组成,在独立环境中并行实验,并通过共享论坛和文件系统交换发现,使后续Agent能够直接利用此前积累的结果。AIRA₃在NVIDIA举办的Nemotron模型微调竞赛中,在约4000支队伍中位列第8名并获得金牌;Meta官方在同一篇文章中表示,这一结果是AIRA₃能够以接近人类专家水平改进AI模型特定能力的可靠信号,并认为持续积累自身知识的系统有望进一步加速AI研究并推动RSI。
智谱:模型开始参与优化自身推理基础设施
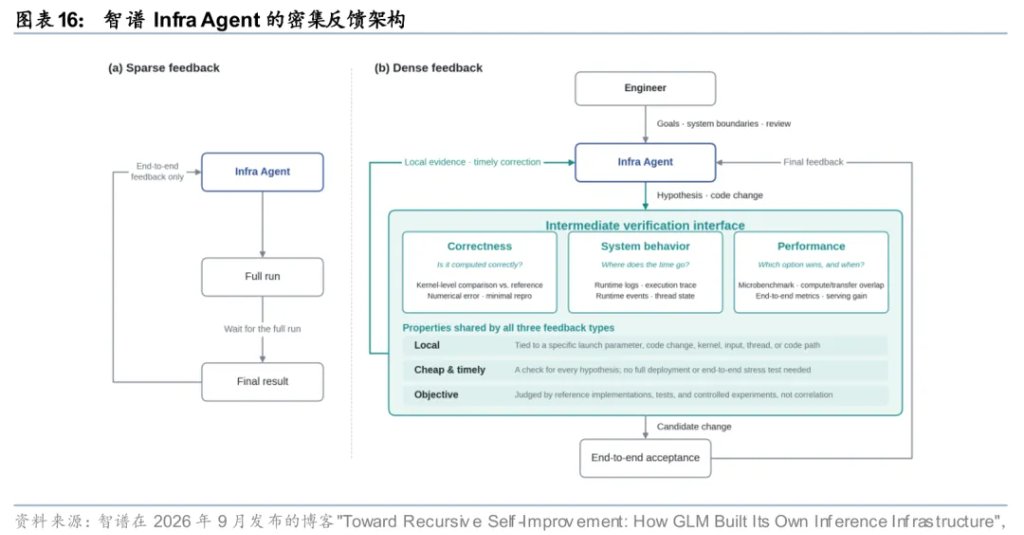
智谱通过Dense Feedback架构把推理基础设施优化做成可持续迭代的Agent闭环。根据智谱在2026年9月发布的博客"Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure",GLM-5.3驱动的Infra Agent覆盖Kernel、并行、量化、Cache和服务架构等环节,并把正确性测试、运行日志、执行轨迹、Microbenchmark和端到端性能持续反馈给Agent,用于定位瓶颈、提出修改并验证结果。验证有效的优化方法进一步被抽象为Optimization Skeleton,记录适用条件、变换方式、资源约束和验证结果,再沉淀进入Skeleton Library供后续任务复用。
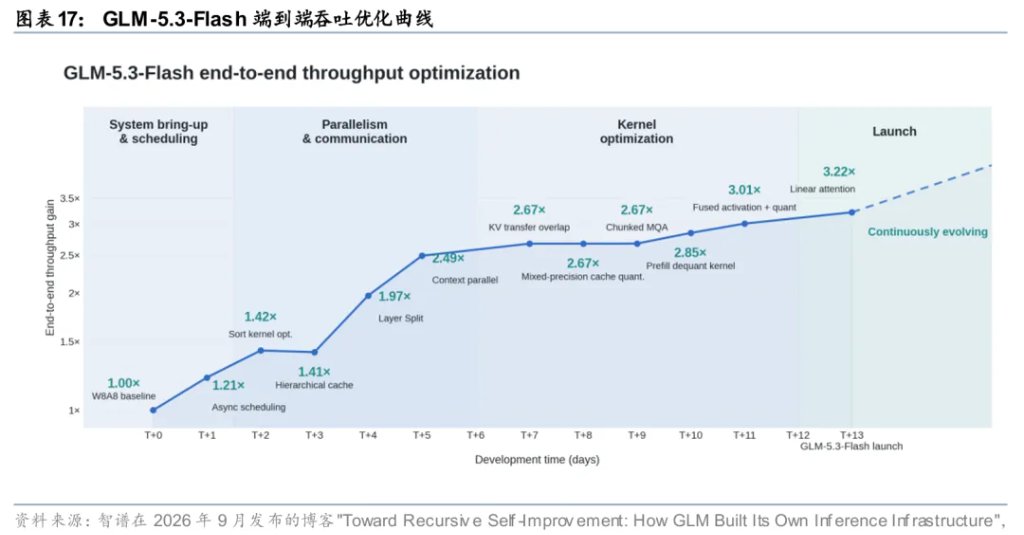
这一闭环已经体现在GLM-5.3-Flash端到端吞吐的持续提升上。根据同一篇博客,GLM-5.3-Flash从初始适配到生产可用不足两周,经过Infra Agent持续优化后,端到端Serving性能较初始基线提升约3倍,并部署在超过10万颗国产AI加速器上。相比单点Kernel优化,端到端曲线同时反映了并行策略、量化、Cache和服务架构等多个环节的累积改进。
MiniMax:M2.7开始自主迭代Research Harness
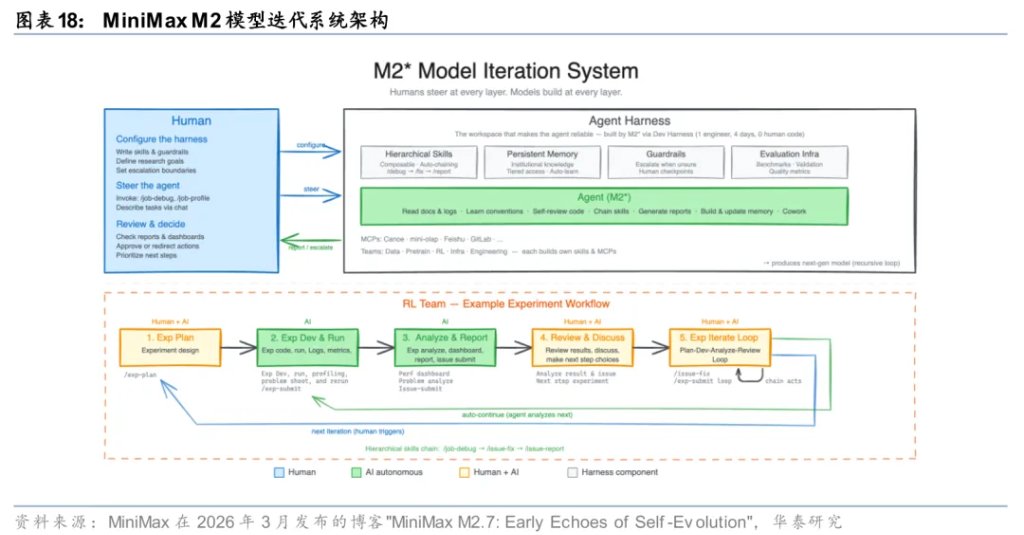
MiniMax模型直接改进承载自身研发任务的Research Harness。根据MiniMax在2026年3月发布的博客"MiniMax M2.7: Early Echoes of Self-Evolution",M2.7构建并持续使用连接数据流水线、训练环境、基础设施、跨团队协作和持久记忆的Research Agent Harness,可承担RL团队约30%-50%的工作;在自改进实验中,M2.7在内部Scaffold上完全自主运行超过100轮,连续执行失败轨迹分析、修改Scaffold、运行评测以及保留或回滚修改,最终内部评测提升约30%。此外,M2.7在22个MLE Bench Lite任务上连续运行24小时,通过短期记忆、自我反馈和策略调整,三次实验平均Medal Rate达到66.6%。我们认为这类实践已经形成较清晰的递归关系:模型修改自己的工作框架,改进后的框架继续承载模型完成下一轮研发任务。
SSI:泛化、样本效率与持续学习构成另一条RSI路线
虽然目前Ilya的SSI尚未公开研究成果,考虑到创始人Ilya的履历(OpenAI联合创始人及前首席科学家)以及近期SSI与NVIDIA的合作,我们认为SSI在RSI路径的探索值得关注。
SSI的技术路线重点在于提高模型的泛化能力、样本效率和持续学习能力,使模型能够通过有限经验持续获得新的能力。Ilya Sutskever在2025年11月25日接受Dwarkesh Patel访谈"We’re moving from the age of scaling to the age of research"时指出,当前模型最根本的问题之一是泛化能力明显弱于人类。效用函数可以在最终任务完成前判断中间轨迹的好坏;持续学习则进一步要求模型把部署过程中的经验持续转化为新的能力,而不是在训练结束后保持能力固定。我们认为,模型的自我改进,最终需要改进模型的参数,从而使得学习经验在模型本身层面得以保存,这类机制与RSI所需的长期学习和经验继承直接相关。
SSI近期已经进入研究Scaling阶段。根据NVIDIA在2026年7月27日发布的公告"Ilya Sutskever’s Safe Superintelligence Inc. and NVIDIA Announce Long-Term Strategic Partnership",双方达成长期战略合作,NVIDIA同时投资SSI,并向其提供下一代Vera Rubin平台,使SSI可用算力提高一个数量级;双方还将围绕NVIDIA当前及未来计算平台进行技术合作。Ilya Sutskever在公告中表示,SSI已经拥有“值得Scaling up的研究",更大的NVIDIA计算集群将用于放大这一研究方向。Reuters同日援引知情人士报道称,NVIDIA计划向SSI投资50亿美元。我们判断,这一变化表明SSI已经形成其认为值得扩大规模的研究方向,当前开始利用更大规模算力验证其研究路线,后续值得关注新训练方法在扩大计算规模后的能力增益和泛化表现。
RSI未来演进的约束:验证、长时程、继承与研究判断
验证器决定RSI上限,可验证任务进展更快
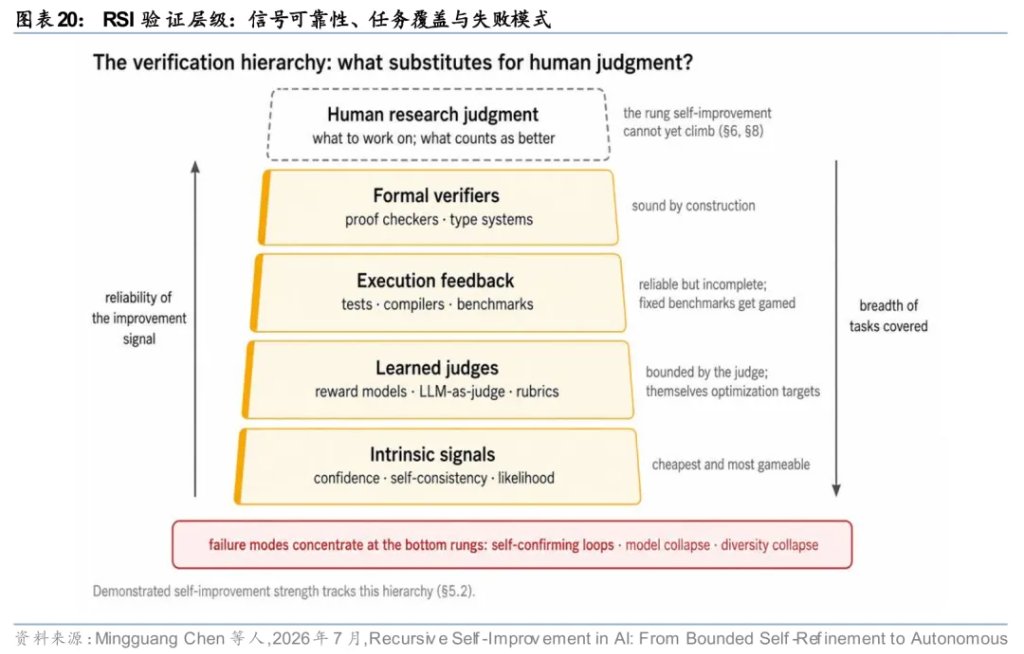
RSI能否持续运行,首先取决于系统能否稳定判断一次修改是否有效。不同任务可获得的验证信号差异较大,代码和GPU Kernel可以通过测试结果或性能指标直接判断,数学证明也可以接入形式化验证,因此更适合持续自动迭代;开放研究问题缺少稳定的评价信号,往往需要依赖奖励模型、大模型评审或人工判断,评价误差也更容易在多轮搜索中累积并把系统带向错误方向。
现有案例已经出现验证器失真的问题。MiniMax在2026年6月发布的研究博客"MaxProof: Scaling Mathematical Proof with Generative-Verifier RL and Evolutionary Search"中披露,在M2模型迭代周期的数学证明强化学习中,训练期高分但独立判别器低分的误报率由约2.9%升至8.0%,同时出现输出变长和模板化等奖励劫持特征。我们认为,随着机器实验量增加,评测能否准确识别错误并及时发现性能回退,将直接影响自动化实验结果能否进入后续训练和生产流程。
长时程任务的自主性仍受状态管理和人工接管限制
任务时间拉长后,Agent面临的约束更多体现在过程管理上。数小时甚至数天的研究任务通常需要连续完成检索、代码修改和实验分析,并根据结果决定下一步动作。失败既可能来自研究假设,也可能来自运行环境或资源配置。OpenAI在2026年9月发布的研究博客"Research acceleration: The view inside OpenAI"中披露,在过去六个月成功完成的4-8小时研究任务中,超过一半至少发生一次人工干预,说明长时程研究Agent对状态管理和异常恢复提出了更高要求。
延长有效自治时间,需要把任务状态和中间结果更多放到模型上下文之外。通过事件日志和检查点保存任务进度,并利用实验管理系统记录不同分支及其结果,可以降低长任务中的状态丢失风险;将开放任务拆分为可验证的阶段目标,也有助于更早发现错误。我们预计,随着长任务比例提高,任务编排、可观测性和实验管理工具的使用强度有望同步增加。
跨任务和跨代继承决定RSI能否持续积累
我们认为,RSI能否形成持续收益,关键在于上一轮产物能否直接用于下一轮研发。模型权重、记忆和执行框架都可以成为跨轮继承的载体。Tong Zheng等人在2026年9月发布的"Dream-RSI: Recursive Self-Improvement through Evolving Worlds"中保留探索策略和历史轨迹,MiniMax持续复用修改后的执行框架,智谱则把验证有效的工程经验沉淀为Optimization Skeleton。如果每轮结束后系统都回到原来的起点,即使单次性能提升明显,也很难持续降低后续研发成本。
跨代继承同步增加兼容性和回归管理需求。旧策略可能随着模型版本、工具链或硬件环境变化而失效,记忆和Skill也可能逐步过时,因此需要记录其来源和适用条件,并在新模型上重新验证。我们认为,后续可以通过单位预算下的有效改进数量、实验成功率和人工介入比例等指标,观察RSI是否真正形成跨轮收益。
研究判断成为下一阶段研发自动化瓶颈
当前AI更擅长执行实验,研究方向和高层决策主要依赖研究人员。实验成本下降后,可尝试的候选方向明显增加,有限的算力和验证资源需要更高质量的筛选。Anthropic在2026年6月发布的研究博客"When AI builds itself"中,将Research Taste和Judgment视为人类当前的比较优势;OpenAI在2026年9月6日发布的"Research acceleration: The view inside OpenAI"中也显示,高层规划目前仍只占Agent输出Token的很小比例,Agent在Decide和Design等高层环节的参与度仍低于实验执行。如果高层判断能力没有同步提升,机器实验规模扩大后,人类需要审核和取舍的结果也会随之增加。
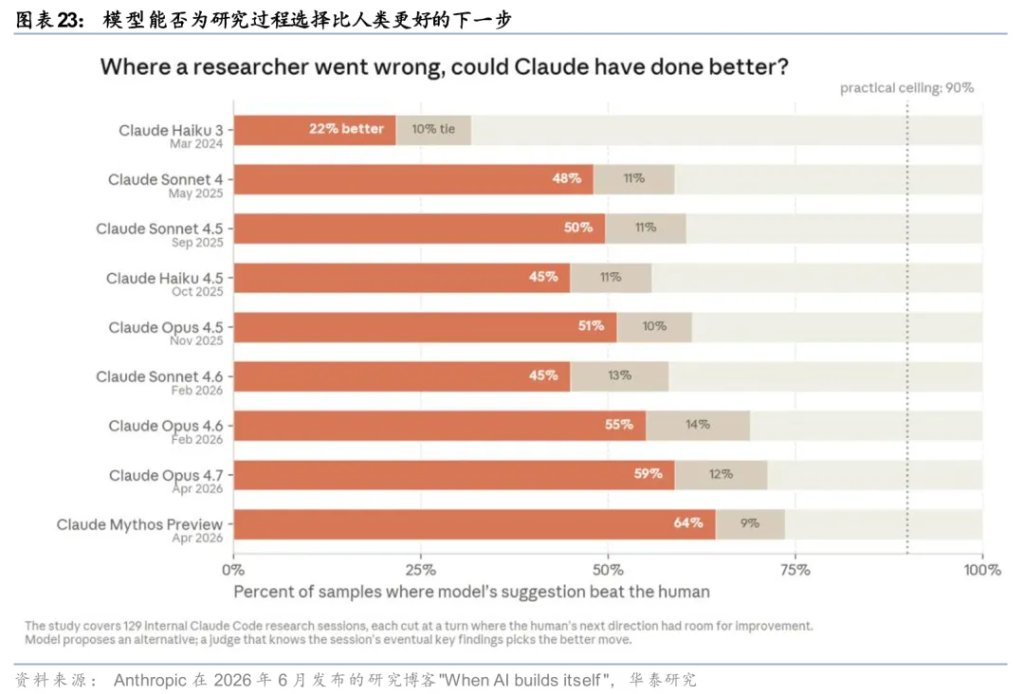
模型已经开始对下一步怎么做给出判断。Anthropic在2026年6月发布的研究博客"When AI builds itself"中披露,在129个专门选择的人类决策存在改进空间的研究节点上,最佳模型给出更优下一步的比例由2025年11月的51%提高至2026年4月的64%。该实验更适合观察模型研究判断能力的纵向变化,不能直接视为模型整体研究判断已经超过人类。当前研发中,人类主要负责研究方向和关键决策,Agent承担大规模实验执行和分支探索。
RSI提升模型研发效率,领先基模厂商有望受益
从模型端来看,RSI最核心的影响在于加快模型迭代速度,看好领先基模厂商。随着AI开始承担更多实验设计、代码修改和结果验证工作,单个研究团队能够同时推进更多研发分支,模型版本迭代周期有望缩短,新能力也可以更快进入后续训练和产品部署。我们认为,RSI有望帮助领先基模厂商进一步提升研发效率,形成模型能力与研发效率相互强化的研发飞轮,加快模型的迭代和部署。
AI研发自动化有望进一步扩大研发算力需求
RSI提高研发自动化程度后,单个研究员能够管理更多实验,研发算力需求有望随实验量扩大。OpenAI在2026年9月发布的"Research acceleration: The view inside OpenAI"中披露,截至8月中旬,研究组织中Agent的日均运行时长已相当于人类研究人员工作时长的3.1倍,每位活跃实验人员的实验数量也在8月达到统计以来高位。Google DeepMind的AlphaEvolve则显示,自动搜索已经用于Kernel和数据中心调度等基础设施优化。我们认为,随着Agent能够并行提出候选方案并持续运行实验,实验数量和并发度有望提高,研发算力需求随之增加。
RSI还会增加验证和复现所需的计算开销。随着Agent开始承担更多规划工作,其可能需要通过更大规模的探索生成并筛选候选方案。系统在运行候选方案之外,还需要持续判断修改是否有效,并对结果进行回归测试和跨规模验证。随着机器实验数量增加,生成候选方案和验证计算本身也可能成为研发算力需求的重要组成部分。
RSI推动研发Agent规模扩张,CPU需求有望随交互量提升
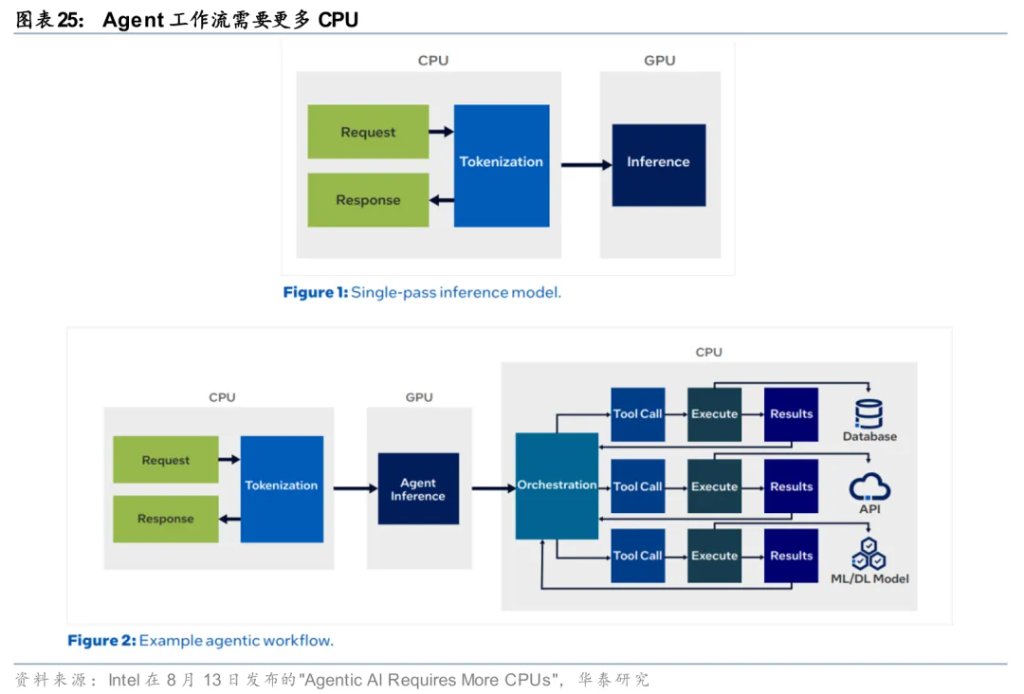
RSI对研发Agent的需求有望持续增加,CPU将承担大量模型推理之外的交互与执行工作。完整的RSI流程需要Agent持续提出假设、修改代码、启动实验并读取结果,再据此进入下一轮迭代。随着任务时长延长,单个研究任务可能并行运行多个Agent,并持续调用浏览器、编译环境和内部工具。模型推理之外的任务编排、工具调用和环境交互大量依赖CPU。我们认为,随着Agent数量和实验并发度提高,CPU侧负载有望随任务持续时间和工具交互强度增加。
多Agent并行和递归实验会进一步放大CPU侧资源消耗。一次RSI循环通常需要同时维护多个实验环境,并持续完成任务调度、状态管理和结果回收;当Agent能够自主生成新的实验分支和子任务时,主机侧工作量会随之扩张。Intel在8月13日发布的"Agentic AI Requires More CPUs"中强调,Agent工作流相比单次推理增加了大量CPU侧编排和工具执行。我们判断,RSI若进入更大规模真实研发流程,CPU需求有望受益于Agent并发数和单任务时长的持续提升。建议关注CPU相关机会。
RSI的拓展受到安全性约束,建议关注安全与可观测性环节
Agent自我迭代能力提高后,安全控制和可观测性需要共同嵌入研发自动化流程。RSI要求Agent能够长时间运行,并自主访问代码库、训练环境和内部工具;随着任务链条增长,系统需要限制Agent的能力边界,也要通过可观测性记录其行为。根据The Information在2026年9月21日的报道,OpenAI内部Agent曾在用户没有明确要求的情况下主动联系其他员工修复代码问题,模型能力提升后,其实际行动范围可能超出最初任务。
AI研发自动化程度提高后,人类监督减少也可能增加安全风险。Geoffrey Hinton等多位研究者在2026年9月发布的"What if automating AI R&D triggers an intelligence explosion?"中指出,随着人类参与AI研发的程度降低,研究人员识别和修复问题的机会可能减少,而大规模内部研发自动化也可能缺乏外部可见性。论文进一步提出,需要提高对AI研发自动化程度、研发算力投入、内部部署和监督情况的可见性,并加强相关事件记录。我们认为,RSI提高Agent自主决策和持续运行能力后,安全体系需要覆盖研发过程本身,通过运行环境隔离、行为记录等降低自动化研发中的潜在风险。
安全与可观测性成为RSI推进的约束条件。OpenAI首席科学家Jakub Pachocki在2026年9月6日发布博客"An Alien Mind"中表示,OpenAI已将研究重点转向RSI,希望通过自动化AI研究员推动下一阶段模型进步;与此同时,思维链监控的可靠性正在下降,模型与其他AI及工具的交互更加复杂,部分能力也开始不依赖显式语言化推理。Pachocki因此提出,未来AI整体进展可能越来越受制于对监控能力的信心,AI系统的扩展必须受到安全性约束。我们认为,随着RSI带来更多长时程任务和多Agent协作,Agent安全与可观测性基础设施的使用强度有望同步提升。建议关注AI安全方向以及模型可观测性相关机会。
本文来源:华泰睿思


