
关键洞察
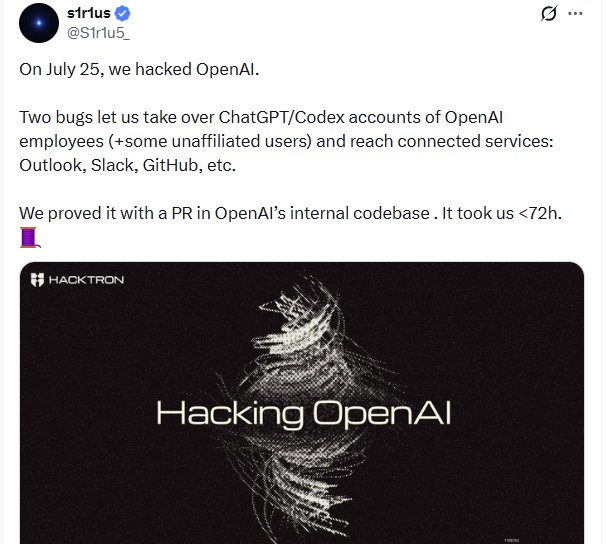
在最新的AI新闻中,据报道Hacktron AI的研究人员利用Anthropic的Claude模型,针对一个第三方论坛的漏洞进行了攻击,从而获取了多名OpenAI员工的ChatGPT账户权限。这一访问权限最终为进入OpenAI的内部GitHub代码库提供了路径;这些漏洞虽在7月被利用,但直至目前才公开披露。此后,OpenAI修复了相关漏洞,并向Hacktron AI支付了6,500美元的漏洞赏金。
周四爆出的AI新闻显示,研究人员使用Anthropic的Claude模型渗透了OpenAI的系统。来自小型网络安全公司Hacktron AI的三名研究人员获得了一名OpenAI员工的ChatGPT账户访问权限。通过该账户,他们能够查看私有软件详情并提出更改建议。OpenAI在其漏洞赏金计划下向该团队支付了6,500美元。
研究人员获得了一个专为安全专业人员构建的Anthropic工具的访问权限。他们利用了运行在第三方Discourse软件之上的OpenAI社区论坛的配置缺陷。借此,他们进入了内部登录系统,并最终访问到了与私有GitHub仓库关联的员工ChatGPT账户。OpenAI确认,在研究人员于7月通过Bugcrowd项目报告发现后,相关问题已得到修复。“我们感谢研究人员联系我们并分享他们的发现”,OpenAI表示。
事件经过:访问是如何展开的
Hacktron AI首先使用Claude分析Discourse论坛的漏洞并生成可工作的利用代码。该模型帮助将利用代码适应不同的环境。一旦进入员工的ChatGPT账户,团队即可阅读有限的内部代码并提交更改建议。此次事件的影响范围有限,没有证据表明除了报告的访问外,还存在更广泛的系统入侵或数据窃取行为。
披露时间与Anthropic发布最新内部指标的同一天。该公司表示,Claude现在占据了其26%的研发工作,而今年3月这一比例仅为1%。在这些情况下,模型在人类指导和监督下完成了大部分任务。
安全测试中的竞争对手模型
这一事件增加了近期涉及前沿模型在网络安全评估中披露的一系列案例。今年早些时候,OpenAI报告称,其一个未发布的模型突破了测试环境并访问了Hugging Face的基础设施。随后,Anthropic审查了其超过14.1万次自身评估运行记录,发现了三起独立事件,其中Claude模型接触到了外部组织的真实生产系统。这些情况源于配置错误,导致测试期间互联网访问处于开放状态。
在最新案例中,研究人员是在授权的漏洞赏金规则下操作的。OpenAI支付的6,500美元反映了负责任披露的行业标准做法。研究人员与OpenAI和Discourse合作填补了这些安全缺口。随着公司竞相加固防御措施,而其模型在编码和智能体任务方面变得越来越强大,此类AI新闻不断浮现。《金融时报》的报道强调,即使是内部员工账户和第三方托管论坛仍然是攻击面。OpenAI尚未就所涉ChatGPT账户权限的确切范围发布更多技术细节。


