
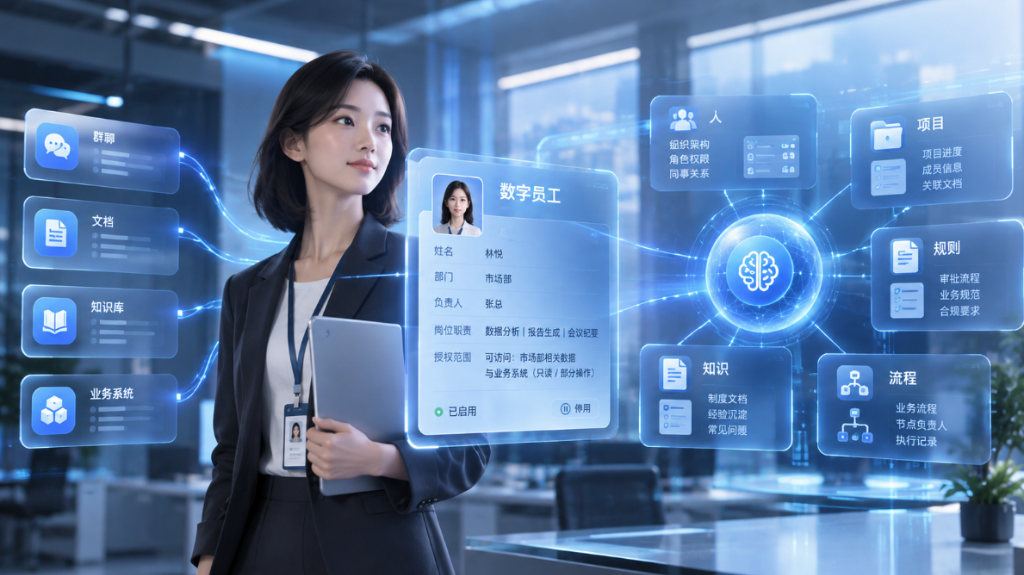
9月22日的云栖大会上,千问办公一次发布了六项企业能力。
最抓眼球的是“数字员工”:它有名字、部门、负责人、岗位职责和授权范围,能被停用,执行记录也可以追溯。看起来,AI终于从一个悬浮在桌面上的工具,变成了组织架构里有工牌的同事。
但如果只盯着这张“工牌”,很容易错过发布会上更重要的四个字:企业上下文。
按照千问办公的描述,它要连接群聊、文档、知识库和业务系统,从中识别人、项目、流程和规则,再根据具体任务调取相关信息。换句话说,数字员工能不能干活,越来越取决于它背后有没有一套持续更新的公司记忆。
这意味着,办公Agent的竞争进入了一个新阶段。
过去大家比谁会做PPT、整理表格、生成报告;接下来真正拉开差距的,是谁知道这家公司发生过什么、现在按什么规则运转,以及一件事究竟应该找谁。
第一轮竞争,像在考一个陌生的临时工
过去一年,办公Agent最常见的演示方式,是给它一份文件,再要求它完成一项任务:汇总销售数据、制作汇报PPT、寻找公开资料、整理会议纪要。
这种测试很直观,也容易传播。任务有明确起点和终点,几分钟后就能看到成品。
但它测出的主要是模型、工具调用和文件操作能力。放进真实公司后,问题很快会变复杂。
一笔退款算不算当季收入?华北地区那张异常订单要不要计入?同一个客户在CRM和财务系统里用了两个名字,应该怎么合并?报告里的“重点客户”,指合同金额、回款金额,还是战略等级?
这些问题靠公开知识和通用模型很难回答,因为答案藏在公司的历史、口径和权责关系里。
近期一次办公Agent横评就暴露了这个问题。同一份存在缺失部门、退款、跨季度订单和异常金额的销售流水,三款产品算出的季度总额最高相差57.7%。差异很大一部分来自它们对可疑订单采取了不同处理方式。
这组数字并不等于某一家产品更差。它真正说明的是:办公任务表面上是算表,底层却是在替企业做判断。
Agent可以读懂单元格,却未必知道财务口径;可以找到异常,却未必知道公司过去如何处理;可以交付一份完整报告,却未必清楚谁有权决定把哪笔订单算进去。
当模型能力逐渐接近,谁能取得并正确使用这些内部信息,才开始成为新的分水岭。
“懂公司”不是多塞几份文档
企业上下文听起来很像升级版知识库,实际比知识库多了一层关系。
普通知识库解决的是“公司有哪些资料”。企业上下文还要回答:这些资料属于哪个项目,谁负责这个项目,什么规则适用于当前任务,哪些信息已经过期,谁有权看到,结果最终应该写回哪里。
千问办公给出的路径分成连接、理解和复用。
先把群聊、文档、知识库和业务系统接进来;再把里面的信息整理成人、项目、流程规则等实体;最后根据任务按需加载,而不是把整家公司一股脑塞给模型。
这套设计的价值,在古茗茶饮的案例里比较容易理解。古茗把飞书文档、知识库、答疑群和培训日程组织成门店运营知识空间,面向近万名一线员工。配方、设备巡检、开台打烊等内容被拆成实体与关系,不同岗位保留不同权限。
店员询问海报张贴规范时,系统需要做的已经不只是“搜索海报”。
它要知道提问者是谁、属于什么门店、承担什么岗位、哪些版本的规范适用,以及在一堆培训资料里哪一段才与当前问题有关。
这也是企业上下文与长上下文窗口的区别。模型一次能读多少字,解决的是容量问题;企业上下文解决的是,公司里哪些信息彼此相关,哪些规则应该在此刻生效。
古茗案例目前没有披露效率、准确率或经营改善,适合用来说明产品形态,尚不足以证明效果。但它展示了一个方向:办公Agent正在从“拿到文件后替你加工”,走向“长期待在组织里理解业务”。
新护城河,长在公司的日常协作里
模型可以更换,企业上下文很难在一夜之间重建。
一个真正懂公司的Agent,需要长期积累组织关系、项目记录、业务词汇、历史决策和员工反馈。它还要跟着公司变化:员工转岗、项目更名、审批规则调整、客户等级改变,都会影响后续任务。
这让办公平台获得了一个天然位置。
钉钉、飞书、企业微信原本承载的只是沟通、文档和流程。Agent进入以后,这些散落的记录开始成为理解企业的原料。谁离组织的日常协作更近,谁就更容易获得新鲜、连续、带权限的信息。
因此,办公Agent的竞争重点正在发生迁移。
早期竞争看模型能不能写、工具能不能调、任务能不能跑完;下一阶段看平台能不能建立一套持续更新的企业上下文,并让不同Agent共同使用。
这也会改变商业上的黏性。
过去企业更换办公软件,最头疼的是搬文件、改流程、培训员工。未来还要迁移一层更隐形的资产:人和项目的关系、企业自己的业务词汇、Agent使用过的规则、历史反馈形成的偏好,以及已经验证过的任务路径。
文件可以批量导出,组织关系和决策语境很难完整打包。
对于厂商来说,这是一条比单纯模型能力更深的护城河;对于企业来说,它也可能成为新的锁定成本。
上下文越多,责任反而越重
“懂公司”并不天然等于“做得对”。
千问办公称企业上下文会继承企业在即时通信系统中的组织、身份和权限体系。这个设计可以让Agent在取数前完成权限裁剪,同时也继承了现实中的旧问题。
一个多年没人维护的群、一份权限过宽的文档、已经离职却仍在项目空间里的账号,过去只是权限管理中的隐患。进入企业上下文后,这些错误可能变成Agent完成任务时可以主动调用的信息。
关系建错、规则过期、历史材料互相矛盾,同样会被带进答案。Agent知道得更多,也可能更有把握地执行一条已经失效的规则。
前面那次销售流水测试也提醒了这一点:多拿到数据,只解决“看见”的问题;异常订单如何认定,仍需要企业提供明确口径,并让最终判断有人负责。
所以,企业上下文的质量不能用接入了多少文档来衡量。更有价值的指标是:信息能否追溯来源,权限是否随人和岗位更新,业务规则有没有负责人,出现冲突时Agent会继续猜还是把问题交还给人。
真正成熟的企业上下文,既是一套知识系统,也是一套责任系统。
企业选的不是最聪明的助手,而是最可控的公司记忆
接下来企业做办公Agent选型,同题实测仍然重要,但测试方法需要向前再走一步。
与其只给三家产品同一份Excel,不如给它们一个需要跨系统完成的真实任务:从群聊找到项目变化,从合同确认约束,从CRM核对客户身份,再按最新审批规则生成下一步动作。测试过程中临时更换负责人、撤销一份文档权限、更新一条业务规则,看系统能不能及时反映变化。
这样的测试更麻烦,却更接近企业真正购买的东西。
企业购买的不只是一个能替员工操作电脑的Agent,而是一套把组织信息转化为行动的基础设施。它要足够懂业务,也要让企业知道它为什么这样做、用了哪些信息、谁为结果负责。
同时,企业自己需要保留一份可迁移的上下文资产:业务词汇表、权限模型、流程规则、决策记录和验收样本。它们应该属于企业,而不是只存在某个办公Agent的产品内部。
办公Agent的第一轮比赛,考的是谁能像一个熟练的临时工,快速把眼前的任务做完。
第二轮比赛,考的是谁能在公司里待得足够久,理解那些从未完整写进任何一份制度里的关系和规则。
到了这一轮,最强的模型未必就是最懂公司的产品。而企业真正需要守住的,也不只是文件和数据,而是让任何一个Agent都能理解自己的那套公司语境。
本文来自微信公众号「AI原生Lab」,持续拆解真实AI落地案例,分享企业AI实践与方法论。


